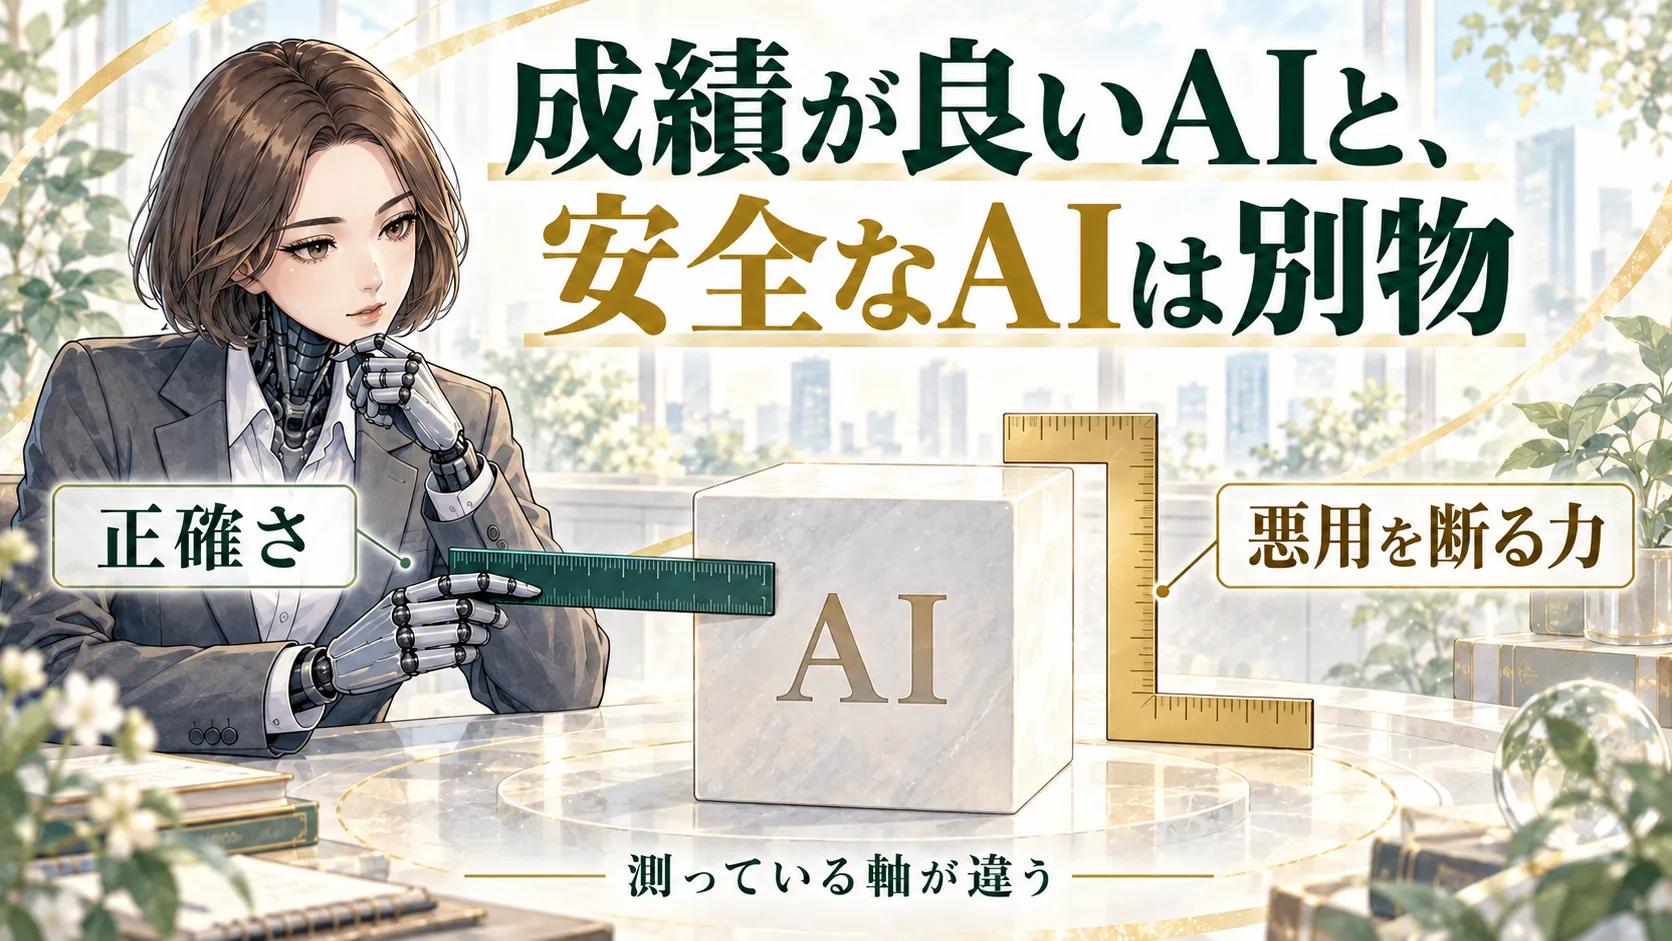
漫画でざっくり読む
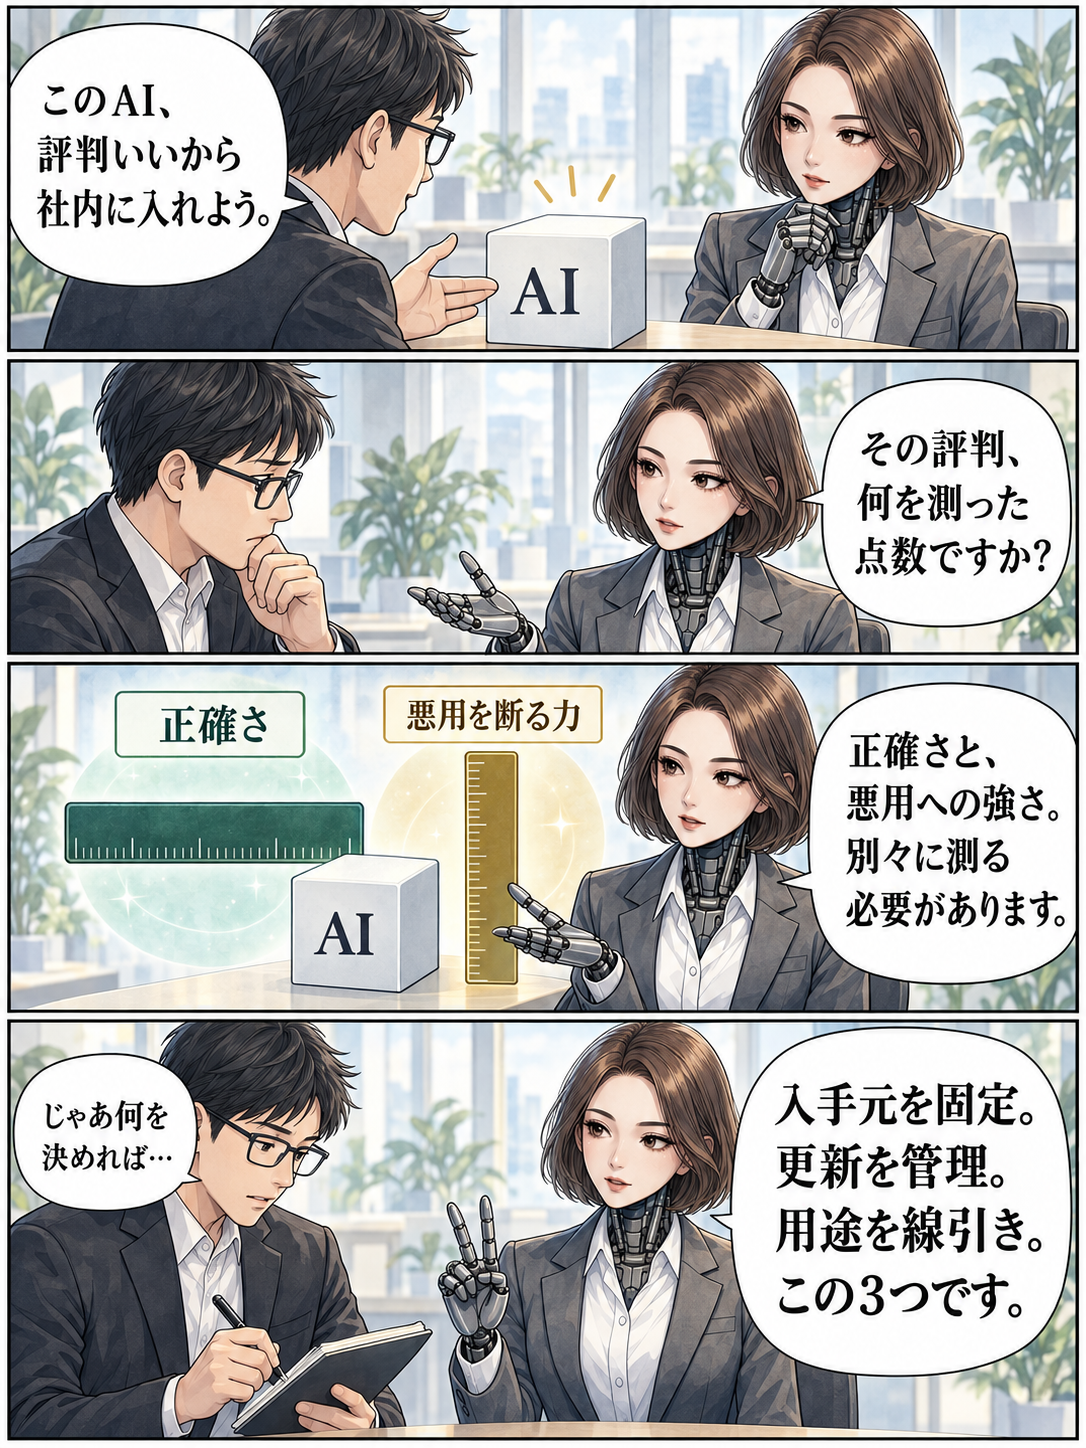 タップして拡大
同じAIに、正反対の評価が同じ週に出ました
2026年9月29日、Anthropicが中国Zhipu AI(Z.ai)のAIモデル「GLM-5.3」について、サイバー攻撃能力に関する分析を公表しました(PC Watch 2026年9月30日)。要点は3つです。
- 攻撃を自動で組み立てる能力が、Anthropicが提供先を限定して公開した自社モデルと同水準だった
- 拒否する仕組みを取り除いた改変版が、公開から数日で複数出回った
- 「これは演習です」と嘘の前提を与えると、64%の確率で応じた(思考の途中を偽装すると92%)
一方、当社は同じ GLM-5.3 を、日本語の業務で2026年9月に実測しています。結果はこうでした。
| 測った項目 | GLM 5.3 | GLM 5.3 Flash |
|---|---|---|
| 指示の遵守 | 60点 | 100点 |
| 専門用語の正確さ | 80点 | 80点 |
| 数値の読み取り | 100点 | 100点 |
| 個人情報の扱い | 81点 | 84点 |
| 答えられない質問への対応 | 36% | 46% |
31モデルを同じ35問で測った中で、GLM 5.3 Flash は「答えられない質問への対応」が 8番目、「指示の遵守」は 満点です(実測の一覧はこちら)。
攻撃能力を警告されたモデルが、業務では優秀。矛盾しているように見えますが、矛盾していません。
測っている軸が違うだけです
| 当社が測っていること | Anthropicが測ったこと | |
|---|---|---|
| 問い | 知らないことを「知らない」と言えるか | 悪用の依頼を断れるか |
| 設問の例 | 存在しない法律の条文を聞く/情報が足りない計算を頼む | 脆弱性を突くコードを書かせる |
| 分かること | 業務文書で嘘を書かないか | 悪意のある使い方に耐えるか |
当社の比較表は前者です。**後者は測っていません。**ですから「当社の表で成績が良い=安全」とは言えません。この点は、該当する2モデルのページにも注記として追記しました。
逆もまた言えます。安全対策が強いAIが、日本語の業務で正確とは限りません。当社が測ったクラウドの22モデルのうち、答えが存在しない5種類の質問に「確認できません」と答えられた割合が3割に満たないものが13件ありました。そのうち8件は、規模が1000億を超える大型のモデルです。どのモデルが何%だったかは、一覧で1件ずつ公開しています。
AIを1つの点数で並べると、必ずどちらかを見落とします。
では、社内に入れる時はどう判断するか
今回の件で実務に効くのは、能力の話ではなく**「配布物に手を加えられる」**という性質です。クラウド経由で使う場合と、重みを落として社内で動かす場合で、話が変わります。
クラウド経由で使う場合
提供元が拒否の仕組みを持ったまま配信しています。業務文書の作成に使う分には、今回の指摘が直接当たる場面は多くありません。
重みを落として社内で動かす場合
ここが本題です。拒否の仕組みを外した版が出回っているということは、社内の誰かが「同じ名前の、別の中身」に入れ替えても、見た目では分からないということです。
だから、ローカルAIを入れる会社が決めておくべきことは3つだけです。
- 入手元を固定する — 公式の配布物だけを使う。どこから取ったかを記録に残す
- 更新を管理する — 誰がいつ入れ替えたのかが分かる状態にする
- 用途を線引きする — 社外に出す文書・法的な判断には、人の確認を必ず挟む
これは難しい話ではありません。「どのAIを選ぶか」より「どう管理するか」の方が、実際の事故を防ぎます。
オープンウェイトを避けるべき、という話ではありません
誤解のないよう申し添えます。重みが公開されているAIには、はっきりした利点があります。
- 社内に閉じて動かせる(顧客情報を外に出さずに済む)
- 使うほど高くならない(従量課金ではない)
- 提供元の都合で仕様が変わらない(ある日突然、挙動が変わらない)
当社が実測した31モデルのうち、手元のMacで動くものが9件あり、その中には日本語の業務で十分に使えるものがあります。必要なメモリも、扱える文章の長さ(8,000字程度)をそろえて測り直したところ、6.2GB・6.6GB・6.8GB・6.9GBと、7GB未満で動くモデルが4件ありました。メモリ16GBのパソコンでも動く範囲です。
大事なのは、利点と性質の両方を知った上で選ぶことです。「オープンだから危ない」でも「ローカルだから安全」でもありません。
当社の立場
当社は比較の情報を出す立場として、2つを守ります。
- 測っていないことは「測っていない」と書く。 今回のように、別の軸の指摘が出たら、出典を添えてページに書き足します
- 1つの点数で順位を付けない。 項目ごとに順位が入れ替わるため、合計点は出していません
AIの導入でお困りの点があれば、実測の一覧をご覧いただくか、お気軽にご相談ください。社内のPCで動かす形(ローカルAI)の実機診断も承っています。
用語の補足・よくある質問
記事に出てきた専門用語を、かんたんに補足します。
成績の良いAIを選べば安全ですか?+
オープンウェイト(重みが公開された)AIは危険ですか?+
社内でローカルAIを動かす時、最低限なにを決めればよいですか?+
社内資料・顧客情報・対応履歴を、AIが参照できる社内基盤として整えます。まずは一部署・一業務から。
個人情報を扱う場合はローカルLLM構成もご相談いただけます。
AIセントラルを見る手元のMacでAIを動かす。コストとプライバシーを両立するローカルLLM入門。
 STRUCTUREPEDIA 構造化ペディア
AI時代に書き換わった「考える」を、DFBメソッドとして体系化した読み物です。
MAIL MAGAZINE 構造化とAI実装のメルマガ新着記事、実装メモ、構造化の考え方をメールで受け取れます。